
將 Day 25 的「全局群體歸因分析」推進至「個人化微觀診斷」層次。利用冠軍模型 LightGBM 與 SHAP 瀑布圖(Waterfall Plot)、單一樣本力導向圖,針對測試集中預測正確與預測邊界模糊的個別受試者,拆解模型從基礎基準值出發、各特徵如何像天平兩端正負推拉形成最終機率的完整決策路徑,產出具備醫療臨床價值的個人化用眼健康評估報告。
一、為什麼群體模型需要「單一樣本可解釋性」?
在 Day 25 中,我們看清了整個母體的大局觀 —— Eye_Dryness_Level、CESI_Score 與 Sleep_Hours 是全場三大主導特徵。但在臨床眼科諮詢或數位健康管理 App 中,使用者與醫師關心的永遠是:
「為什麼『我』會被判定為高風險?」
「是哪一項生活習慣把我推向了危險邊緣?如果我增加睡眠,風險能降低多少?」
SHAP的局部可解釋性正好解決了這個痛點:
今天將選出兩位具備強烈代表性的受試者進行深度個案病理解構:
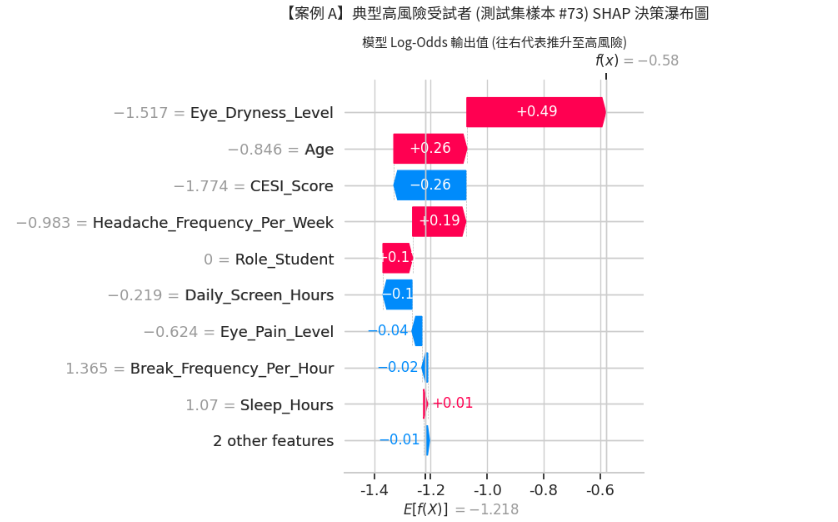
案例 A(典型高風險個案):模型以極高把握度正確判定為高度疲勞風險。
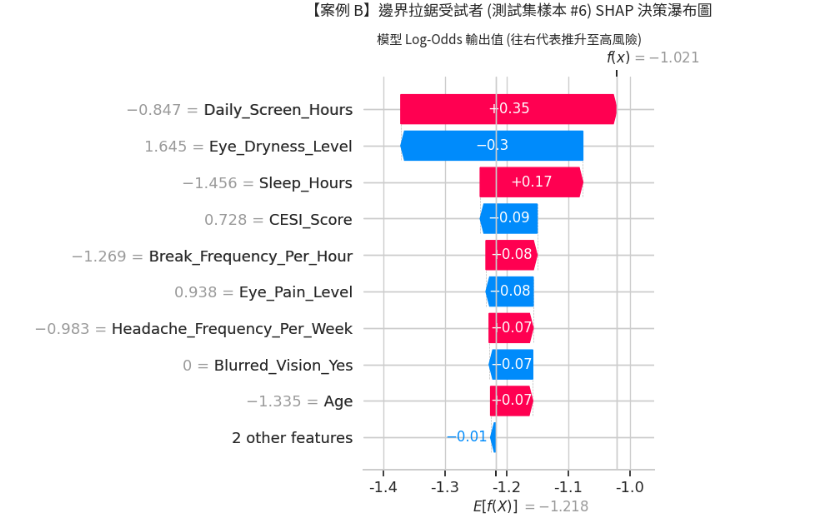
案例 B(邊界模糊爭議個案):特徵處於模糊過渡帶,各特徵相互拉扯的複雜病例。
二、撰寫單一個案SHAP診斷與視覺化腳本
在 Colab 中新增儲存格,使用 shap.plots.waterfall 與客製化文字解析器產出個案報告:
# ==========================================
# Day 26:LightGBM 模型之單樣本 SHAP 瀑布圖診斷
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

import shap

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 確保已繼承 Day 25 的 explainer 與 shap_values
# shap_values_high 針對 Class 2 (High Risk)
if 'shap_values_high' not in locals():
    explainer = shap.TreeExplainer(lgb_clf)
    shap_values = explainer(X_test)
    shap_values_high = shap_values[:, :, 2]

# 2. 挑選代表性病例
# 取得測試集真實標籤為 High (2) 且模型精準預測為 High 的樣本
y_pred_lgb = lgb_clf.predict(X_test)
y_prob_lgb = lgb_clf.predict_proba(X_test)

correct_high_indices = np.where((y_test.values == 2) & (y_pred_lgb == 2))[0]
# 選取高風險預測機率最高的一位作為典型案例
case_a_idx = correct_high_indices[np.argmax(y_prob_lgb[correct_high_indices, 2])]

# 選取一位真實為 High 但預測機率接近邊界 (約 0.35~0.45) 的邊界爭議案例
borderline_indices = np.where((y_test.values == 2) & (y_pred_lgb != 2))[0]
case_b_idx = borderline_indices[0] if len(borderline_indices) > 0 else 0

# 3. 繪製案例 A 瀑布圖 (典型高風險個案)
plt.figure(figsize=(10, 6))
plt.title(f'【案例 A】典型高風險受試者 (測試集樣本 #{case_a_idx}) SHAP 決策瀑布圖', fontproperties=my_font, fontsize=13, fontweight='bold', pad=15)
shap.plots.waterfall(shap_values_high[case_a_idx], max_display=10, show=False)
plt.xlabel('模型 Log-Odds 輸出值 (往右代表推升至高風險)', fontproperties=my_font, fontsize=11)
plt.tight_layout()
plt.show()

# 4. 繪製案例 B 瀑布圖 (邊界爭議受試者)
plt.figure(figsize=(10, 6))
plt.title(f'【案例 B】邊界拉鋸受試者 (測試集樣本 #{case_b_idx}) SHAP 決策瀑布圖', fontproperties=my_font, fontsize=13, fontweight='bold', pad=15)
shap.plots.waterfall(shap_values_high[case_b_idx], max_display=10, show=False)
plt.xlabel('模型 Log-Odds 輸出值 (往右代表推升至高風險)', fontproperties=my_font, fontsize=11)
plt.tight_layout()
plt.show()

# 5. 建立文字化臨床診斷處方輸出器
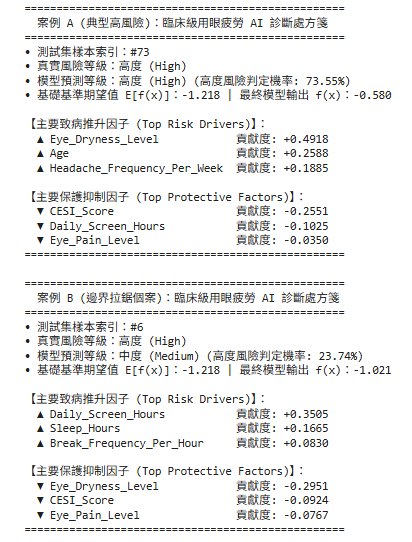
def generate_clinical_report(sample_idx, case_name):
    sv = shap_values_high[sample_idx]
    orig_features = X_test.iloc[sample_idx]
    high_prob = y_prob_lgb[sample_idx, 2]
    pred_label = ['低度 (Low)', '中度 (Medium)', '高度 (High)'][y_pred_lgb[sample_idx]]
    true_label = ['低度 (Low)', '中度 (Medium)', '高度 (High)'][y_test.iloc[sample_idx]]

    print(f"==================================================")
    print(f"  {case_name}:臨床級用眼疲勞 AI 診斷處方箋")
    print(f"==================================================")
    print(f"• 測試集樣本索引:#{sample_idx}")
    print(f"• 真實風險等級:{true_label}")
    print(f"• 模型預測等級:{pred_label} (高度風險判定機率: {high_prob*100:.2f}%)")
    print(f"• 基礎基準期望值 E[f(x)]:{sv.base_values:.3f} | 最終模型輸出 f(x):{sv.values.sum() + sv.base_values:.3f}\n")

    # 提取推進與壓制的前三大特徵
    contrib_series = pd.Series(sv.values, index=orig_features.index).sort_values(ascending=False)

    top_push = contrib_series.head(3)
    top_pull = contrib_series.tail(3).sort_values(ascending=True)

    print("【主要致病推升因子 (Top Risk Drivers)】:")
    for feat, val in top_push.items():
        if val > 0:
            print(f"  ▲ {feat:<28} 貢獻度: +{val:.4f}")

    print("\n【主要保護抑制因子 (Top Protective Factors)】:")
    for feat, val in top_pull.items():
        if val < 0:
            print(f"  ▼ {feat:<28} 貢獻度: {val:.4f}")
    print("==================================================\n")

generate_clinical_report(case_a_idx, "案例 A (典型高風險)")
generate_clinical_report(case_b_idx, "案例 B (邊界拉鋸個案)")


 iThome鐵人賽
 看影片追技術